
AI模型越来越强,药为什么还是难出
Lumina Research synced content from 06_DailyIntel/03_Daily_Output/daily_drafts/2026-08-10/nature_reviews_ai_pharma/wechat_publish.html.
Lumina Research
AI模型越来越强,药为什么还是难出
先说结论
工具在进步,能改写临床结果的证据仍然有限。下一程不看测试集分数又高了多少,而看模型有没有进入真实项目的取舍——有没有帮团队少做错推进、多做对选择。
Lumina 导语
行业里不缺新模型,也不缺“AI 正在改变制药”这类句子。缺的是一套更不容易自欺的成功标准。
《Nature Reviews Drug Discovery》最近刊出剑桥大学 Andreas Bender 等十多位横跨学术与产业作者的综述长文:技术能力在往前走,临床层面的硬证据目前还很单薄。
我们关心的不是再给这篇论文做摘要,而是四个问题:现在卡住什么、解法朝哪走、眼下该盯什么、未来更愿意看到什么。
先说结论:工具进步了,出药证据还没跟上。
长文回顾了“AI 优先”公司的管线分布:多数项目仍在临床前,进入早期临床的有一批,真正走到后期的很少。这不能只用“药本来就慢”一笔带过。过去多年,行业叙事反复许诺周期会明显缩短。若许诺很大、后期仍稀少,中间一定有东西被说轻了。
技术侧并不空白。蛋白结构预测和设计、更细的测量手段、更广的药物模态,都让单点预测看起来更强。矛盾在于:预测变强,并不自动等于项目决策变好,更不等于患者端结果变好。
作者用了一个很克制的说法:眼下更像是“证据不足”,而不是“已经证明没用”。这个调子很重要。它挡住两种偷懒:一边说泡沫破了、AI 没戏;一边把个别早期项目的顺风,直接记成平台胜利。
在我们看来,问题可以拆成三层,它们经常被混在一句话里讲。
第一层:把活性分子当成药。 数据库里,有活性的分子可以到上百万量级;真正上市的药大约只有上千量级。两者优化的东西不一样。前者常看结合和体外活性,后者还要过暴露、安全、疗效和可开发性。新闻和融资材料里,常把“找到配体”写成“发现药物”——好听,却会系统性低估后面的路有多长。
第二层:数据没有看起来那么干净。 生物读出高度依赖条件:细胞系、剂量、时间点、患者代谢、共病和生活方式,都会改答案。化学空间又极大,而且充满合成习惯和项目偏好带来的偏置。你照亮的往往只是一小片区域,换一片就未必成立。这时再喊“多喂数据就行”,常常是在回避更难的问题:你的代理指标,到底能不能代表体内和临床真正要的东西。
第三层:分数进步,不等于决策进步。 常见流程是:划分训练和测试,某个指标涨了,就宣布新高度。可模型最终要服务的是项目里的取舍:推进还是停下,先做哪个实验,毒性风险能不能承受。淘汰毒性和挑选活性,能容忍的错误类型完全不同。如果分数从来没有进入真实的设计、合成、测试循环,也没有留下可核对的决策痕迹,它对出药的意义就很有限。
把三层叠在一起,就会出现一种熟悉的景象:材料很亮,管线仍早,归因很满,证据很薄。这不是某几家公司的道德问题,而是成功标准设错了位置。
外部压力还会放大这种错位。出药成本长期承压,公司需要显得在改变;融资端常带着高承诺入场;论文和基金又更奖励“数据集上刷分”。于是“看起来进步很快”和“实际项目里的决策有没有变好”,可以长期脱节。
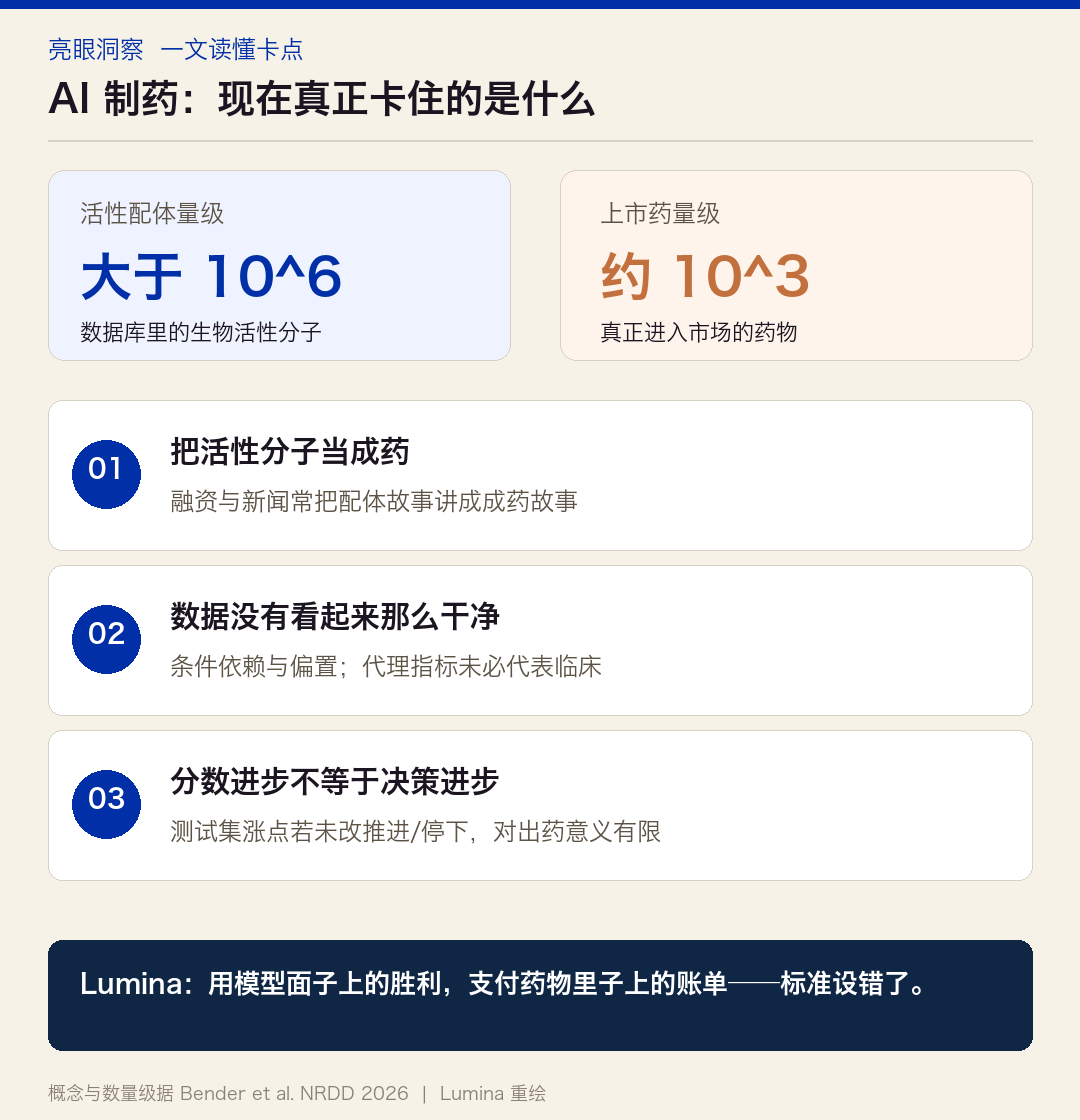
图:三层卡点与配体/成药数量级(Lumina 据 NRDD 2026 重绘)
当下核心问题:行业仍在用模型面子上的胜利,支付药物里子上的账单。
解法不是再换一个更大的模型名字,而是把成功标准挪回药物发现真正发生的地方。
1. 先写清要服务的决策,再选方法和指标。 动手之前先问:这个模型是用来淘汰风险、挑选苗头、排序优先级,还是辅助剂量和暴露判断?不同用途下,该看的指标和能接受的错误不一样。指标服从决策,而不是决策服从指标。
2. 先证明代理指标靠谱,再大规模铺数据。 值得扩产的数据,是那些已经显示出对体内或临床相关终点有预测力的读出。否则堆得越多,噪音和自我安慰也越多。健康的数据工作分两步:小范围搞清楚“什么值得测”,再在有限、相关的空间里加密,并说清楚模型适用边界。
3. 让模型进入真实项目循环,而不是停在演示。 有价值的落地通常长这样:模型建议改变了实验优先级,改变了某次推进或停下,并且这件事可以被同事复核。嵌进设计、合成、测试、分析的循环,比多做一张架构图重要。
4. 让临床结果,包括失败,回流到发现端。 如果临床前和临床被数据墙完全隔开,模型就只能在实验室好看的世界里学习。次优结局和失败,恰恰是最贵的监督信号。没有它们,团队容易在已经讲顺的故事里打转。
5. 把“发论文”和“改决策”拆成两套考核。 两者可以并行,但不能互相顶替。只奖励分数、不奖励决策质量,进步幻觉会自我繁殖。
这些方向并不新,也不浪漫。它们的共同特征是:更难讲成口号,却更接近出药。
Lumina 的立场
支持认真做方法、做数据和做转化的人;不支持把活性分子当药、把测试集当临床、把融资承诺当证据的叙事。
如果你做投资、BD 或研发管理,不必先争论哲学,可以直接改问题清单。
看一家 AI 药物发现团队时,优先问这些:
1. 你们最拿得出手的案例,是活性分子、临床候选,还是进入人体之后仍然站得住的贡献?
2. 被写成“AI 发现”的资产,生物学是不是老地图上的重访?旧靶点、旧机制也可以有价值,但定价逻辑不同。
3. 模型有没有改过具体的推进或停下?有没有书面记录,而不是口头回顾?
4. 你们最常用的代理指标,对体内或临床终点的预测关系证明到哪一步了?
5. 验证有没有前瞻成分?换一个真实项目,结论是否还站得住?
6. 失败和误导有没有被讨论?只报命中、不报带偏,价值要打折。
7. 收入或合作节点,绑的是模型交付,还是临床进展?
看自己团队时,可以用更粗的三档自检:一档是测试集更好;二档是进了实验循环、改了优先级;三档是改了推进或停下,且可核对。大量公开叙事停在一档,少数到二档,三档往往含糊。买方若只为一档付三档的价钱,就会持续错付。
看预算时,问杠杆在不在刀刃上。 同样是改善,降低错误推进、提高患者匹配,往往比“再多画一批分子”更贴近研发成本的痛点。早期热闹不等于最值钱。若 AI 开支几乎不碰失败模式、分层和决策节点,回报故事会长期对不齐。
看不同应用时,预期要拆开。 结构预测与设计能力进步清楚,但从结构走到可开发药物仍长。部分物化性质预测更可用。生成式设计能提出新结构,新不等于可合成、可成药。试验招募和流程效率有时先见到收益。临床结局预测主张很多,可推广性和偏差问题也大。允许工具层和流程层先兑现,不要把流程改善直接说成临床突破。
这些标准对国内外团队和买方同样适用。能讲清决策贡献的,走到合作桌上更硬;只会讲平台和分数的,迟早会遇到更抠细节的对手盘。
我们不是在等一句“AI 已经赢了”或“AI 已经输了”。我们更愿意在未来一到两年里,看到这些更具体的东西:
1. 归因说得清。 新进临床的项目如果强调 AI,应能说明 AI 改的是哪一步决策,而不是只出现在标题里。
2. 后期信号逐渐出现。 后期项目不必一夜之间变多,但方向应可见:有信息量的读出、更清楚的患者定义、经得起追问的开发路径。
3. 验证方式公开化。 出现能被同行听懂的做法:决策场景是什么、错误成本是什么、如何前瞻检验,而不只是离线刷分。
4. 失败数据开始被学习。 组织愿意把次优结局送回发现端,而不是只把成功案例做成广告。
5. 对外叙事升级。 融资和合作材料从“我们很会找分子”,转向“我们如何改进取舍、如何降低错误推进、如何服务成药路径”。
这也是我们后续持续跟踪 AI 药物发现时的主线:不追每一篇新模型新闻,而追决策有没有变好、证据有没有变硬、叙事有没有变老实。
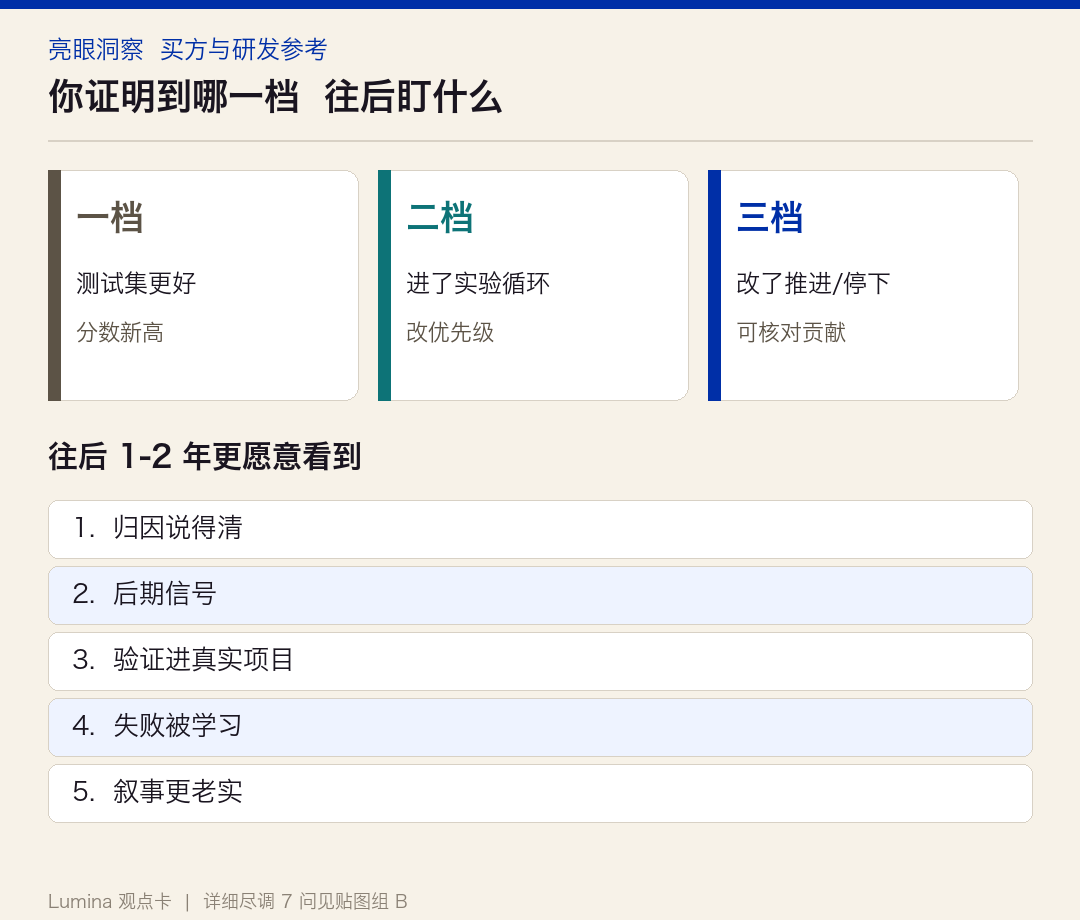
图:成熟度三档与往后观察点(Lumina)· 完整尽调 7 问与数据图见两套贴图
Bender 等人的长文,最有用的地方不是提供裁判句,而是逼行业换问题:你优化的是分数,还是取舍?
我们的答案很直接。分数可以看,取舍才算数。找到活性分子值得高兴;离把分子做成药,中间仍是药物发现最贵、最难、也最不该被话术抹平的那一段。
向光而行,不是把复杂事情调成鸡汤,而是让该被看见的证据露出来:决策有没有被照见,失败有没有被学习,承诺有没有被临床核对。
#AI药物发现 #NatureReviews #成功标准 #尽调清单 #亮眼洞察
资料来源:Bender A. et al. Artificial intelligence in drug discovery — what it is, where we stand and the path forward. Nature Reviews Drug Discovery (2026). https://doi.org/10.1038/s41573-026-01496-2
观点为 Lumina 阅读与产业判断,不代表期刊或作者立场。管线阶段与数量级转述自该长文及其引用综述。
延伸阅读:贴图组 A(原文数据重绘)、贴图组 B(Lumina 判断与尽调清单)将另行发布。