
《Cell》八位学者同期发声:AI 缺的从来不是算力,而是这三类数据
Lumina Research synced content from 06_DailyIntel/03_Daily_Output/daily_drafts/2026-09-22/ai_causal_data_gap_cell_voices/wechat_publish_ready.md.
Lumina Research
《Cell》八位学者同期发声:AI 缺的从来不是算力,而是这三类数据
《Cell》八位学者同期发声:AI 缺的从来不是算力,而是这三类数据
✦ 亮眼导语
1. 核心转折(新闻与认知反差):9 月 17 日《Cell》邀请八位顶尖学者复盘 AI 与生命科学的结合。大家原本期待听到新算法与算力飞跃,学者们却共同揭示了一个反直觉的瓶颈:制药的难点从来不是计算,而是人类根本还没搞清病因;AI 现在也推不出病因,因为目前喂给大模型的绝大多数是“只看不动”的静态观测数据,无法推导真实的致病因果。
2. 底层缺口(三个尺度的共同困境):从分子、细胞到临床试验,AI 面对着相似的阻碍:蛋白质静态结构能预测,但动态功能算不准;单细胞大模型能学到漂亮的数字表征,却不懂细胞真正的调控逻辑;临床试验失败往往不在分子本身,而在患者分层假设。八位学者指出的共同死穴,是 AI 极度缺乏因果数据、功能数据与动态数据。
3. 行业去泡沫(严谨评测倒逼降温):过去几年靠大模型“无假说、暴力堆数据”的狂热正在降温。2025 年《Nature Methods》权威评测显示,七个主流单细胞大模型在基因扰动预测上竟无一跑赢最朴素的线性回归。基础模型在输入端的宽松,代价必须是输出端更残酷的检验,行业不能用跑分的虚假繁荣,掩盖未被解决的生物学真实问题。
4. 产业演进与中国变量:因果数据无法靠网络爬取,必须在湿实验里一次次动手测出来。这意味着 AI 制药的真正护城河,正从“谁的模型大”全面转向“谁能以低成本规模化产出高质量扰动数据”。在算法与建模侧,中国团队已进入全球第一梯队;如果未来拼的是工业级湿实验产能,中国的工程化效率将成为关键的潜在筹码。
---
三周前我们写了虚拟细胞,这次原作者说,目标从来就不是虚拟细胞
9 月 17 日出版的《Cell》上,有一篇很容易被快速翻过去的特稿。它不是严肃的研究论文,没有发布任何新模型,也没有亮眼的新实验数据,属于 Leading Edge 栏目下的 Voices 观点专栏:编辑部约请了八位来自不同细分领域的顶尖学者,各写一段,谈谈 AI 正在如何深刻影响各自的研究领域。
这类学术约稿往往四平八稳、充满客气的展望。但这一期里,有一句话说得格外扎心:
> 「因为目标从来就不是一个虚拟细胞。目标是一个多尺度人体的因果模型。」
说出这句话的,是 insitro 创始人、斯坦福大学教授 Daphne Koller。作为最早把现代机器学习系统引入新药研发的先驱之一,她的判断在业内向来很有分量。
三周前的 9 月 1 日,我们曾发布长文《硅谷 Arc 与腾讯同登〈Cell〉主刊》,深入拆解过虚拟细胞的最新进展:硅谷 Arc Institute 的 State 模型用 1.67 亿个单细胞数据筑底,腾讯生命科学实验室与中南大学联合研发的 UniPert-G2CP 则尝试用大规模 CRISPR 基因筛选数据去反哺小分子药物的表型预测。那篇文章的核心落点在于,虚拟细胞正从纸面蓝图演化为工业级的因果推断工具。
如今,Koller 把行业反思推向了更深一层。在她看来,虚拟细胞本身绝非终极目标,它仅仅是人类通往人体多尺度因果模型的一段必经之路;而在这条路上,眼下最卡脖子的短板,不是算法架构,不是计算算力,甚至不是数据量不够大,而是我们喂给模型的「数据种类」从根上就出了偏差。
这正是本期 Voices 值得深度复盘的原因。八位学者分别来自结构生物学、单细胞生物学、免疫学、空间组学、蛋白质注释与临床试验设计六个截然不同的领域。如果拨开各学科专业术语的包装,你会发现他们其实都在指向同一个隐秘缺口,只是这个缺口在微观的分子、介观的细胞以及宏观的临床患者三个尺度上,各自表现出不同的困境。
在拆解前,有两点事实需要预先讲明。第一,Voices 属于学术观点专栏,文中的论述皆为学者个人的专业研判,并非已盖棺定论的同行评议结论。第二,Koller 本人既是顶尖学者,也是商业机构 insitro 的创始人和持股股东,「因果数据极度稀缺」既是她的学术洞察,也天然契合 insitro 打造高通量自动化实验室的商业定位。我们在原文的利益披露中清楚看到了这一点,后文的判断是否成立,归根结底要看外部客观研究的检验。
---
再多的观测数据,也堆不出真正的因果
这是理解当前 AI 制药瓶颈最核心、也最容易被泛泛一句「相关不等于因果」滑过去的问题。
不妨先来看一个新药立项中极具代表性的场景:你手里拥有几十万名肿瘤患者的组织转录组测序结果与长期随访档案。算法工程师跑完相关性分析,兴奋地告诉你:只要某个未知基因 A 的表达量升高,患者的生存期就会显著缩短,P 值极其优异。
这项结论是怎么来的?本质上是「看」出来的。你只是挑选了一群在自然状态下已经患病的个体,把他们身上同时存在的生物学表型记录了下来。在统计学上,这被称为观测数据(Observational data)。
但此时如果把问题推进一步:若我们开发一款靶向药,把这个基因 A 彻底敲除或阻断,患者的肿瘤究竟会不会萎缩?
这个答案,哪怕你把这批观测数据的样本量从几十万例堆叠到几千万例,也绝不可能推导出来。因为你的问题探讨的是「对系统进行外力干涉后会引发什么改变」,而所有的观测数据,记录的全部是「未施加干涉前系统呈现什么状态」。要得出确切答案,唯一的办法就是有人走进实验室,在真实细胞里真正敲掉基因 A,然后精密测定细胞的后续反应。这部分必须动手干预才能获得的信息,才被称为扰动数据(Perturbation data)。
这正是 Koller 在文中强调的一针见血之处:
> 「因果关系无法被网络爬取,也无法凭空推断;它必须通过主动扰动一个系统并记录其结果来测量。」
她随后补充道,一个以预测为训练目标的机器学习模型,归根到底学到的是「事物之间往往如何伴随发生」,而绝非「是谁引发了谁」;即便模型参数和数据规模再膨胀几个数量级,也无法将前者自动转化为后者。这句话看似基础,却直接击碎了近五年 AI 领域最诱人的一套假设:把全网医学文献、病历记录与公开组学数据一股脑灌进大模型,生物学的深层作用机制就能“涌现”出来。
那么在复杂的人体生命体系中,真实的因果杠杆究竟藏在哪里?Koller 梳理出两个来源,而它们各自带着明显的局限:
- 人类自然遗传学:被她形容为「大自然替人类完成的随机对照试验」。精卵结合那一刻,基因完成了随机重组与分配,天然隔绝了后天复杂的混杂变量。它能确凿地告诉你某个突变基因在人体中确实至关重要,但很难讲清楚这个基因到底通过怎样细密的生化通路在发挥作用。
- 细胞层面的直接实验扰动:即科研人员在实验室里主动操控的靶向实验。它能在微观尺度清晰揭示一个基因的调控动作,但很难直接证明这个机制在真实的重度患者体内到底能不能救命。
只有将自然遗传学的大尺度结论,与细胞级高通量扰动实验的微观结果咬合在一起,模型才有可能从临床结局逆向回溯到分子机制,新药研发团队才能凭借因果确定性、而不是依赖运气去筛选靶点。
这绝非书生论道,生物医药产业早已经为这条逻辑支付过高昂的账单。2024 年发表在《Nature》上的一项重磅研究中,Minikel 与 Nelson 团队全面复盘了 29,476 个靶点与适应症组合,得出的核心结论是:拥有确凿人类遗传学证据支持的药物研发机制,其最终临床试验成功的概率,是没有该类证据支持路线的整整 2.6 倍。
然而,该项研究同时揭示了两个令人深思的数字:在全行业所有评估过的靶点适应症组合中,真正具备遗传学证据支持的仅占 7.3%;而在这些极少数拥有因果线索支撑的靶点中,历史上真正被推进到临床探索阶段的竟然只有 1.1%。
做过药物发现的一线研发人员大都有过切身体会:在生物信息学分析中预测指标惊艳、相关性极强的候选靶点,一旦被送进活体细胞和动物模型,往往十之八九会迅速陨落。这通常不是筛选算法算力不够,而是从起点喂给算法的数据本身就只包含静态相关,缺乏底层因果。2.6 倍的成功率差距,衡量的正是补上真实因果拼图后,新药研发所能换来的巨大胜率飞跃。
Koller 的落脚点很朴素:真正的苦功夫,在于如何规模化、工程化地在实验室中源源不断制造出这类扰动数据,而这也正是终极模型至今仍显遥远的主因。
---
同一个缺口,在分子、细胞与临床三个尺度上反复出现
倘若只有 Koller 一家持此观点,这篇 Voices 充其量算作特定流派的自白。然而掩卷细读你会发现,其余多位在截然不同层面上深耕的科学家,在各自领域竟不约而同地撞上了相似的硬墙。
分子尺度:静态结构算得准了,动态功能依旧算不准
西湖大学卢培龙教授立足于结构生物学前沿。过去数年间,以 AlphaFold、RFdiffusion 和 ProteinMPNN 为代表的算法,已将由氨基酸序列预测蛋白质静态三维结构的命中率推向了惊人的高度。但他十分客观地指出:从序列到结构的预测进展斐然,但从三维结构通向生物学功能的鸿沟依然巨大。
症结不在于模型不够聪明,而在于底层功能训练数据在「数量、质量与统一标准化」层面的长期匮乏。静态结构领域拥有 PDB 蛋白质结构数据库数十年规范如一的高清数据积累,而衡量生物学功能的数据,至今缺乏类似的通用基准池。
现阶段 AI 究竟在哪些分子对象面前步履维艰?卢培龙列出了几个典型瓶颈:动态构象系综(蛋白质在活体中绝非僵死不动的静态模型,而是处在一组动态构象之间高速转换)、超长核酸复杂三维构型、超大蛋白质组装体,以及从头理性设计高催化活性的酶与分子机器。这些难题的共同本质在于:决定生物功能的关键信息蕴藏在分子的动态流变与状态迁移之中,仅凭几张高分辨率的静态快照,根本无法还原全部秘密。
首尔大学的 Martin Steinegger 从大规模蛋白质注释的角度印证了这一观察。在深海、土壤与极地等环境宏基因组样本中,有高达 80% 至 90% 的已知蛋白质在现有库中找不到任何同源序列,常年被贴上“未知功能假定蛋白”的标签。AI 结构比对在此立下奇功:即使两条蛋白的序列完全不同,通过空间折叠比对,研究人员成功帮其中大约一半的未知蛋白重新找回了家族归属。
但 Steinegger 划下的能力红线同样分明:目前的模型极其擅长分辨大尺度的宏观空间构型,但对局部的精细结构差异依然迟钝。他的原话总结道,目前的 AI 模型在「折叠(fold)层面」已能较好地捕捉生物学规律,但下一代模型的决胜前沿,在于将分辨率推进到「单个关键氨基酸残基(residue)」的细微突变与空间变化。
换言之,在分子尺度上,AI 已经基本攻克了静态“外形”的猜想,但功能却往往取决于外形如何运动,以及个别核心位点上的微小调整。这两类至关重要的信息,在当下的公开数据库里几乎是一片空白。
细胞尺度:把细胞当文本读,学到的是数字表征,不是调控逻辑
来自巴斯德研究所的 Laura Cantini 对当前单细胞基础模型的审视更为锐利。她谈到,生命科学领域的大量所谓“细胞基础模型”,底层架构大多直接从处理人类语言(NLP)或图像(CV)的成熟框架中迁移而来。这些架构用来做高维数据的特征提取和表征学习确实高效,但生命系统有着自身严格的内在规律,它由精密的基因调控网络、组织空间架构与动态时间节律所严格束缚。
她给出的警告十分中肯:若长期漠视生物学内生机制的约束,模型迭代很可能会走向歧途,即“训练出一批预测指标看起来不错,却并未可靠扎根于底层生物学机制的脆弱模型”。
这番评价非常公允。Cantini 并没有抹杀大模型的工程价值,她同样认可基础模型在抹平单细胞批次效应方面表现卓越,这是扎实的工程进步。但她明确反对的一种认知是:仅仅把细胞转录状态压缩进一个漂亮的潜空间向量,绝不等于真正解析了细胞为何在特定节点做出生死抉择的调控指令。
普林斯顿大学的 Yuri Pritykin 进一步在免疫学场景中剖析了这一问题。他指出,一个免疫细胞的最终命运,绝不单单取决于自身的基因组与表观遗传状态,它每时每刻都在受制于细胞间的物理碰撞、局部细胞因子信号的强弱、在组织微环境中所处的物理坐标,以及随时间演进的动态历程。
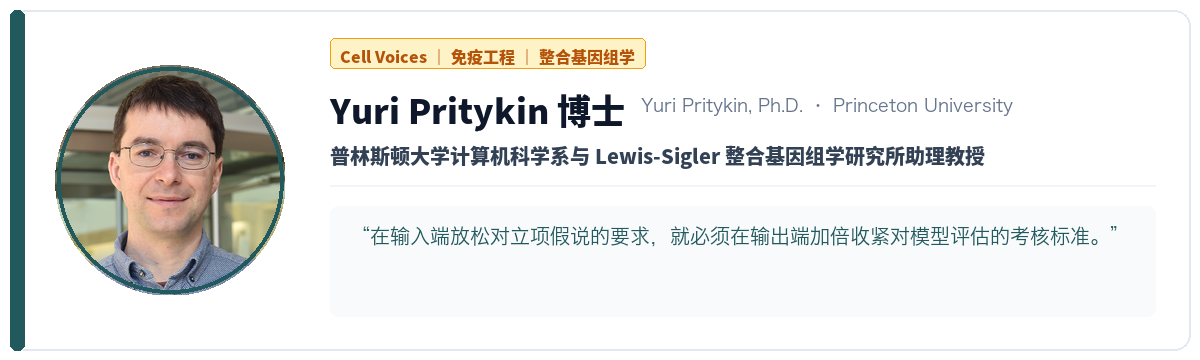
将这段话转换为研发语言便是:要想训练出真正具备临床指导意义的免疫模型,单靠更多堆砌互不关联的单细胞测序快照毫无意义。模型迫切需要的,是同时标记了时间演变轴、空间几何坐标、且忠实记录了特定扰动后应激反应的多模态动态数据。
患者尺度:临床试验失败,常常不在分子本身
剑桥大学教授、Francis Crick 研究所首席 AI 科学家 Mihaela van der Schaar 将因果链条延伸到了终极的临床患者场景。
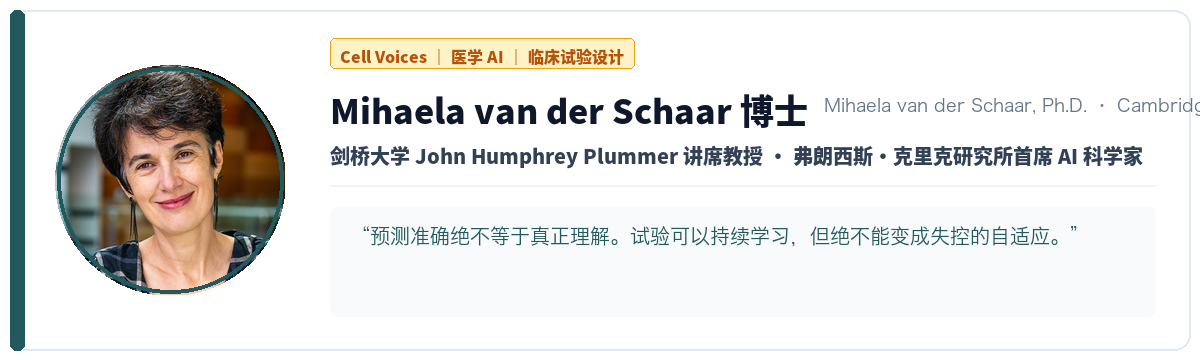
她的观察切中了新药开发最痛的一环:现实中大量临床试验的折戟沉沙,问题往往不在于候选化合物分子本身缺乏活性,而是出在患者入组筛选、临床终点设定、给药剂量方案、给药时机选择,或是那些在推入人体前从未接受过严酷压力测试的前提假设。
在临床管线决策中,这种遗憾屡见不鲜:一款靶向药在三期临床读出阴性结果,项目组的第一反应往往是沮丧地认定“靶点机制已被证伪”,然而深度复盘后往往发现,分子对特定生物机制的调控是起效的,真正的悲剧在于从一开始入组时,最可能真正获益的特定患者亚群就未能被精准识别出来。
van der Schaar 认为,因果机器学习、合成数据以及虚拟数字孪生大有可为之处,正是帮助药物研发团队厘清三项核心任务:哪些特定人群具有真实获益潜力、真实世界亚组数据中哪些信号是稳健的、现行的试验方案设计是否存在致命脆弱点。
但针对临床 AI 的应用,她以极度严谨的态度划定了红线:
- 模型预测准确,绝不等于对疾病病理机制的真实理解;
- 临床试验应当伴随真实世界证据的累积而持续迭代,但持续学习绝不能沦为不受约束、随意更改试验方案的自适应操作;
- 模型驱动的每一步调整,都必须保持百分之百的透明可追溯,必须经过严谨的前瞻性统计学验证,并受制于预先锁定的监管规则。
翻译成通俗的注册监管语言:前瞻性、科学设计的自适应临床试验值得鼓励,但企图借助 AI 模型黑箱在试验中途随意改动方案规则,绝不可能跨过监管门槛。
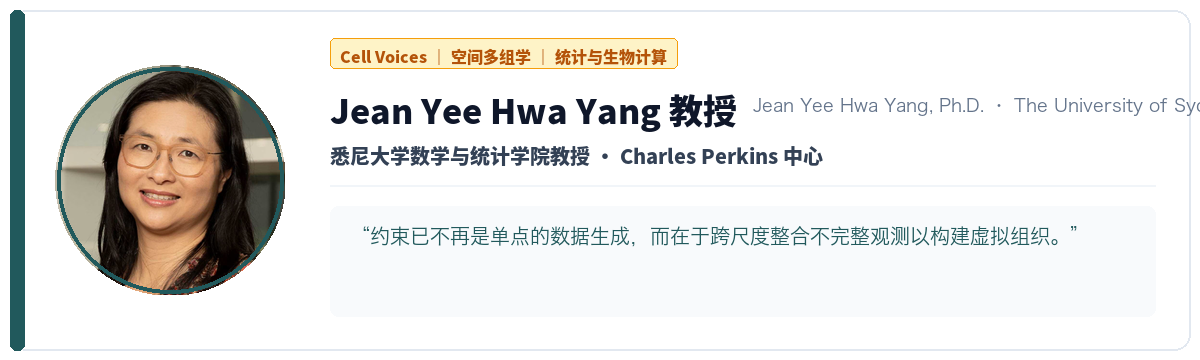
悉尼大学的 Jean Yee Hwa Yang 教授对这三个尺度的困境做了一句凝练的呼应:生物计算当前的瓶颈已经不再是单点的数据生成,而在于跨系统的数据整合。未来的方向,必然是从不完整、异质性的零散观测中重构生命组织的完整分子全貌,从病理切片结合局限的空间信息去逆推高维表达,真正迈向“虚拟组织”的模拟时代。
---
立项逻辑真的松动了,但评测必须全面收紧
前几节梳理了生命科学究竟在哪些数据维度上缺口最大。这期 Voices 还探讨了一个更为深刻的议题:前沿科研与 Biotech 公司的项目立项逻辑正在发生怎样的剧烈质变。
在生命科学几十年的经典科研范式中,所有研究几乎无一例外遵循着一套严密的法则:查阅文献,提出一个极为具体的生物学假说,设计靶向实验验证这一假说,并产生一小批高度针对性的数据。这一范式的优势在于研发资金靶向精准,但缺陷是产出的数据往往高度私有化、离散化,几乎无法被外部模型大规模复用。
Pritykin 敏锐地指出,这套延续几十年的学术铁律正在被基础模型所打破:
> 「正如深度学习减少了对人工特征工程的依赖,基础模型也显著减少了对狭隘假说的依赖——那种过去必须用来为系统性数据生成寻找合规借口的假说。」
换句话说,在当下的科研语境中,科学家可以理直气壮地提出:“我先不预设立场去猜测某个特定假说,而是以纯粹的资源图谱模式,系统性地把整个复杂系统的多模态、跨时空底层数据先高质量绘制出来。”这在十年以前的科研经费评审会上,几乎不可能获批。
然而,Pritykin 紧接着为这种看似自由的立项范式附上了一记警钟:
> 「在输入端放松对立项假说的严苛要求,就必须在输出端加倍收紧对模型评估的考核标准。」
他进一步归纳了必须严格履行的四项行业自律:执行极其残酷的基准对照测试、如实公布模型的能力局限、公开坦承并发表负结果、以及必须与那些有时反而表现更出色的更简单基线模型进行正面交锋。他尖锐地警告:如果行业在数据尚未扎实前就过早地宣布问题已经得到解决,只会严重分散科研界的注意力,让人们对真正未被攻克的底层难题视而不见。
这番警告绝非无的放矢。在过去一年间,外部独立学术团队的一连串严苛评测,已经给火热的行业气氛泼下了及时的冷水。
第一项硬核评测。 2025 年 8 月发表在《Nature Methods》上的一篇重磅评测,将 scGPT、scFoundation、scBERT、Geneformer 和 UCE 五个赫赫有名的单细胞通用基础模型,外加 GEARS 和 CPA 两个专用扰动预测工具,集中置于四个权威数据集上进行“基因敲减后表型扰动预测”的大考。为了形成对照,研究团队特意设置了几个极其朴素甚至略显原始的基线:完全不预测变化的“静态基线”、简单的加性模型,以及基础的线性岭回归(Ridge Regression)。
最终的实测结果令许多人大跌眼镜:在最受关注的单基因扰动后全基因表达预测任务上,七款重金打造的大模型,没有一款能够稳定跑赢最基础的线性回归基准。
第二项大型盲测。 2025 年由 Arc Institute 主办的首届虚拟细胞挑战赛,吸引了全球 114 个国家、1200 多支队伍注册参赛,最终提交方案超过 300 份。赛后主办方在技术复盘中十分坦白地承认:在衡量预测整体偏差的平均绝对误差(MAE)等核心指标上,绝大多数深度学习模型同样未能跑赢简单的经验基线。尽管顶尖方案在特定差异基因识别等维度展现出了实质性的进步,但复盘揭示出一个关键特征:在复杂的生物预测任务中,综合表现最好的往往不是纯粹暴力的深度神经网络,而是深度学习与经典统计学框架深度结合的混合产物。
这两项评测结果必须被理性看待:它们证明的是,在特定任务与特定考核指标下,现有的大模型并不像宣传文案中所宣称的那样无所不能。它们真正的产业警示在于:生命科学计算领域的概念包装与宣称速度,正不可忽视地跑在了实际的客观验证速度之前。
---
护城河正在从模型侧,移向湿实验那一侧
将学者们的反思拼合在一起,指向的产业投资与创业逻辑已经十分清晰。
如果因果数据只能通过物理实验去测量,而无法单靠爬虫与算法去凭空合成,那么 AI 制药的根本护城河就绝不会停留在算法架构本身。
在当下的 AI 生态中,模型架构正经历着极度迅猛的平民化与公开化。Transformer 的各种生物变体、扩散模型在分子生成中的演进、图神经网络在调控网络中的抽象,一篇顶会论文发表后,全球团队在数月之内就能完成代码复现。算法在今天能够为先发者带来的时间窗口,往往很难超过半年。
相比之下,一个能够长期稳定运转、且高通量高标准产出扰动数据的自动化湿实验产线——包括自动化细胞培养系统、高通量 CRISPR 基因编辑筛选平台、单细胞测序多维读出以及严苛的批次质量控制——其搭建需要数以年计的时间沉淀,而且每平稳运转一天,都在为企业构筑出独占的因果数据壁垒。
这方面有一个极具标杆意义的样本:Tahoe-100M。这个由 Tahoe(原 Vevo Therapeutics)于 2025 年初开源、作为 Arc 虚拟细胞图谱核心基石的数据集,囊括了 1 亿个单细胞、1200 种小分子药物扰动、覆盖 50 个癌细胞系及 6 万个药物-细胞作用组合。官方在发布时指出,仅仅这一个公开数据集的扰动数据体量,就是此前全球所有公开发表的药物扰动数据总和的 50 倍以上。
这个「50 倍」的对比,足以让人对生命科学界“因果数据究竟有多贫瘠”产生具象的认知。在此之前,人类在药物扰动单细胞领域公开积累的数据总和,竟然还不如一家初创公司单次实验释放出的体量。
站在早期投资与管线尽调的实战视角,这为业界提供了一个直截了当的审视标准。当一家 AI 制药企业在商业计划书中展示其参数量、网络深度与拟合优度时,最该抛出的核心问题其实只有一句:
> “你的模型训练数据,是在公开发表物里‘看’来的,还是在自己的实验室里‘动手测’出来的?如果是扰动数据,数据是谁生成的,测了多少样本,批次效应如何消除?”
如果答案是“我们搜集整合了全球公开的多组学数据库”,那么它拥有的很大程度上只是静态相关性;如果答案指向一条自主运转、不断吐出高标准扰动数据的实体湿实验产线,它才算握住了通往因果层面的核心杠杆。两者在商业演示文档上或许同样炫目,但当项目推进到三期临床读出的关口时,成败差异将被彻底拉开。
中国团队的坐标与潜在优势
在这场范式迁移的版图中,中国团队的位置同样值得客观梳理。
在 2025 年 Arc 虚拟细胞挑战赛中,中国的百图生科(BioMap Research)团队凭借 xTrimoSCPerturb 模型斩获全球冠军,四川大学 XLearning Lab 团队荣获亚军,力压众多国际顶尖团队。结合三周前腾讯生命科学实验室与中南大学联合开发的 UniPert-G2CP 同样在《Cell》主刊发表,这些硬核成绩足以证明:在单细胞与虚拟细胞的算法建模这一侧,中国团队已经稳稳处于全球第一梯队。
当然,学术与算法竞赛的名次必须严格界定在算法任务本身,它不等于模型已经具备完全替代湿实验的能力,更不能等同于新药临床价值的直接兑现。
真正的产业变量在于后半程。如果行业共识确认了算力不是决胜手、规模化扰动数据才是真命脉,那么中国在新药研发基建上的综合优势将迎来价值重估。国内成熟且具备极高性价比的 CRO/CDMO 工业体系、自动化实验室硬件方案的高效迭代能力、以及在全球范围内具备绝对成本优势的高通量单细胞测序产能,将不再仅仅是研发链条上的代工执行方,而可能沉淀为极具战略意义的数据资产制造中枢。
这是我们基于产业要素演化做出的独立观察。未来 2 至 3 年间,中国顶尖学术机构与 Biotech 能否打破信息孤岛,向全球科学界贡献出若干批具有广泛影响力、模态完备且被高频复用的大规模高质量扰动数据集,将是验证这一战略潜力能否真正变现的试金石。
---
几个可以被检验的研判,以及最近的验证节点
整期《Cell》Voices 并没有官宣任何颠覆性的新成果。它的深远价值在于,让八位身处不同学科一线的求索者,汇聚在同一个讨论场里,平静地替全行业点破了一个朴素的真理:AI 并没有把生命科学凭空压缩成一个纯粹的代码计算题;相反,它以前所未有的清晰度,照亮了生命科学底层究竟缺了什么数据。
从描述自然现象到预测大体趋势,AI 的贡献有目共睹;但若要从单纯预测迈向确凿干预、理性成药,算力无法代偿实验,唯有在微观世界里真刀真枪测出来的因果信号才能支撑前行。
在文章结尾,亮眼洞察留下几个明确可供未来检验的产业研判,以及一个即将到来的核心验证窗口:
1. 资本流向将发生质的切换:在未来 18 个月内,AI 制药领域的成熟融资,将更加明确地流向重度自建高质量湿实验扰动产线的闭环团队,纯算法型外包团队的估值溢价将加速收缩。 2. 顶刊审稿门槛将实质性抬高:在未来一年内,“与简单的经典线性统计基线进行对照评测”,将从审稿人的非强制性建议,逐渐演变为 Nature 系与 Cell 系等顶刊在单细胞建模方向上的默认审稿规范。 3. 功能预测将在垂直场景率先突围:由结构到功能的实质性落地,不会率先发生在通用蛋白质功能的大一统模型上,而会优先在酶催化活性、抗体亲和力成熟等具备高标准化、统一功能读出通路的垂直特定赛道兑现。 4. 最近的实战验证窗口就在今年第四季度:Arc Institute 主办的 2026 年第二届虚拟细胞挑战赛,将任务难度推向了极端。今年的核心考题是:要求模型在完全未见过扰动数据的六个全新细胞系中,实现对 CRISPRi 基因敲低的零样本预测,考核数据将于 10 月 22 日解封,提交截止时间锁定在 11 月 5 日,结果将于 11 月中下旬揭晓。
如果届时绝大多数模型在跨细胞系的未知泛化上依旧难以击败基础基线,则进一步强化了因果扰动数据极端匮乏的判断;倘若有模型实现了坚实的跨越,我们将及时修正当下的评估。
待到挑战赛结果揭晓之时,我们将重回这一赛场,带来第一手的深度追踪。
---
参考来源
1. Changing minds: How AI is transforming the life sciences. *Cell* 189, 5909–5913 (September 17, 2026). DOI: 10.1016/j.cell.2026.08.019 2. Ahlmann-Eltze C, Huber W, Anders S. Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselines. *Nature Methods* 22, 1657–1661 (2025). 3. Minikel EV, Nelson MR, et al. Refining the impact of genetic evidence on clinical success. *Nature* (2024). 4. Arc Institute. Virtual Cell Challenge 2025 Wrap-Up: Winners and Reflections. 5. Arc Institute. The 2026 Virtual Cell Challenge: predicting perturbation responses in cell contexts a model has never seen. 6. Arc Institute / Tahoe. Tahoe-100M open-sourced as inaugural contribution to the Virtual Cell Atlas (February 2025). 7. 亮眼洞察,《硅谷 Arc 与腾讯同登〈Cell〉主刊:解密「虚拟细胞」背后的 AI 制药新版图》,2026-09-01。
*利益披露提示:本文引述的 Daphne Koller 为 insitro 创始人、雇员及股东;Martin Steinegger 声明在 Stylus Medicine 有外部利益;Mihaela van der Schaar 所在的 Cambridge Centre for AI in Medicine 接受阿斯利康、GSK、武田、勃林格殷格翰与麦肯锡资助。以上均见原文利益声明。*
#AI制药 #虚拟细胞 #因果推断 #扰动数据 #单细胞 #基础模型 #临床试验设计 #亮眼洞察